
Biodata: vanliga frågor
Biodata analyserar dina genuttrycksmatriser, utan kod. Modulen är i beta och förbehållen planerna Premium och Team.

Emerit Science-laget

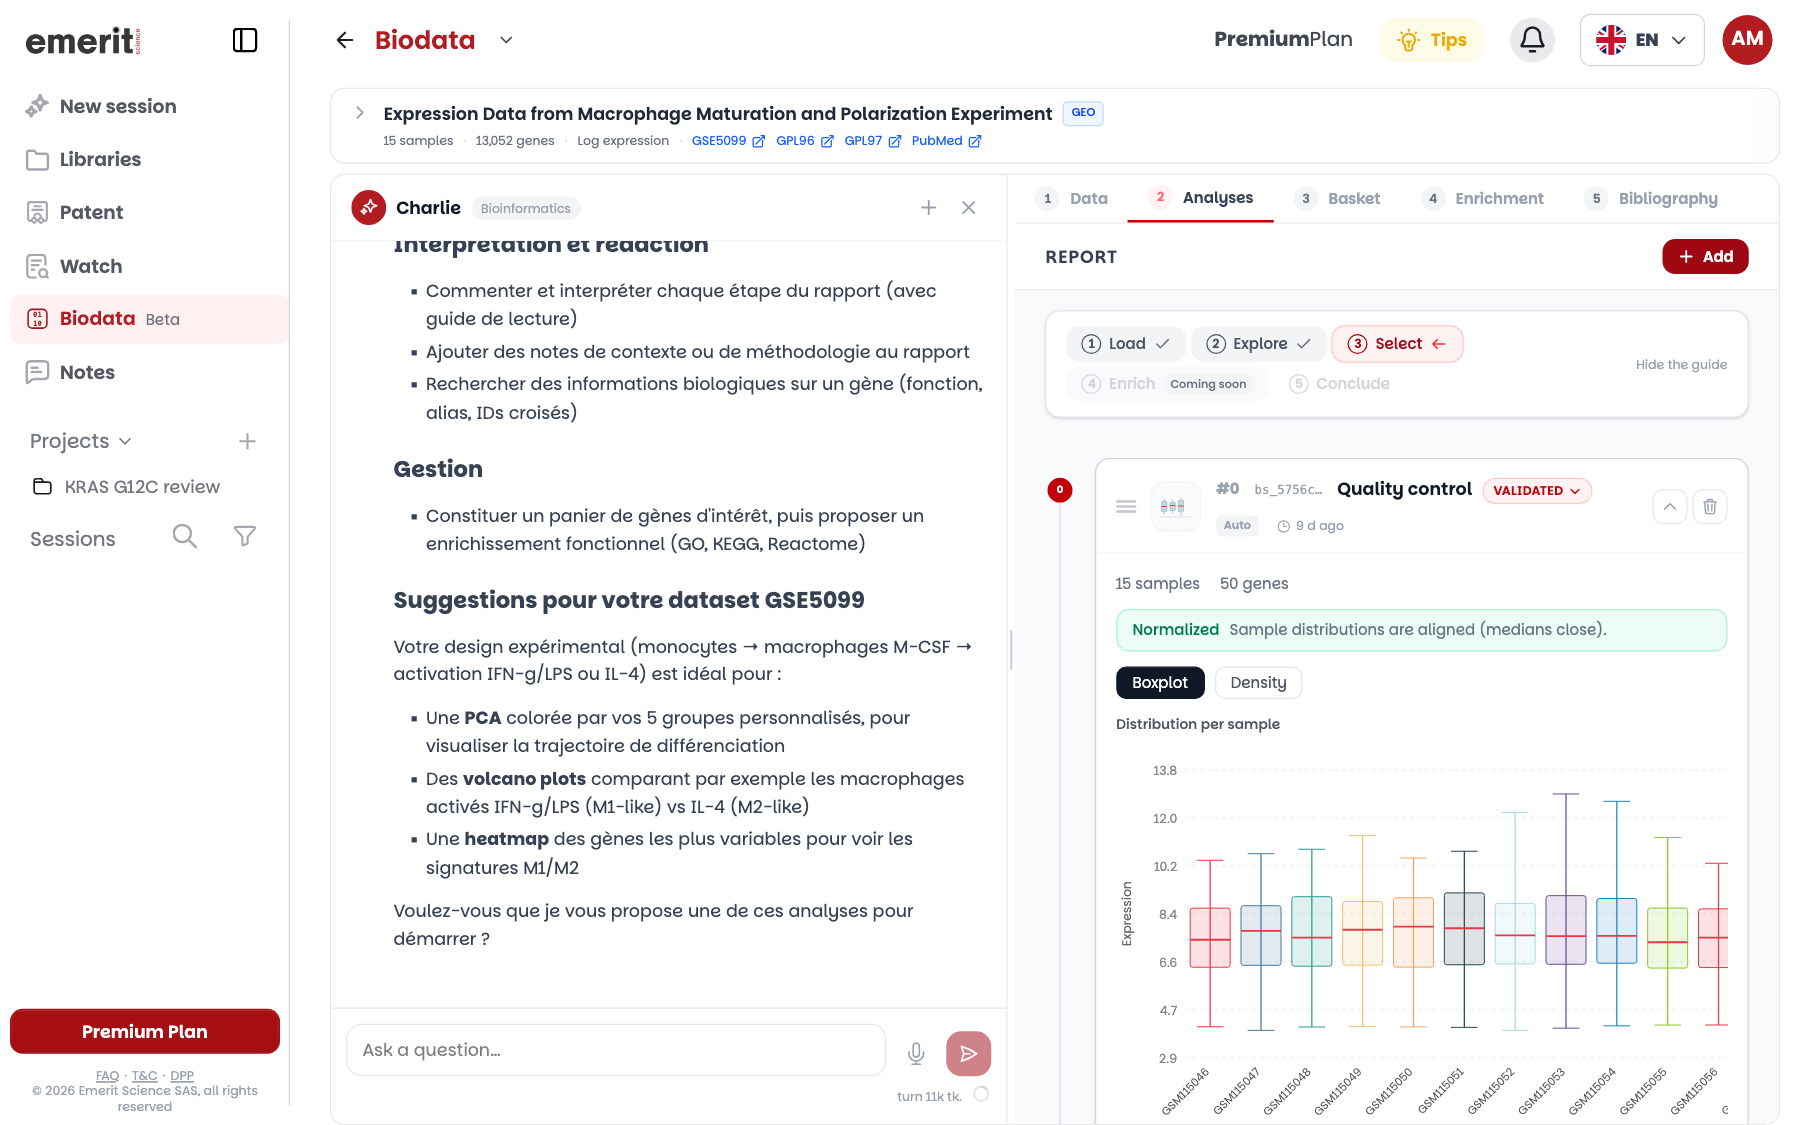
Biodata utgår från en uttrycksmatris: en fil som importeras från din dator, eller en serie microarrays som laddas från NCBI GEO. Där förbereder du data, startar statistiska analyser och samlar sedan de gener som intresserar dig i en korg.
Charlie skriver bildtexterna och svarar på dina frågor om resultaten. Beräkningarna görs däremot av statistikprogram och inte av språkmodellen: se fråga 18.
Aviserat i applikationen, ännu inte tillgängligt
- Funktionell anrikning (GO, KEGG, Reactome): fliken ”Anrikning” visar ”Kommer snart”.
- Bibliografin kopplad till din datamängd: fliken ”Bibliografi” visar ”Kommer snart”.
- En särskild metod för råa RNA-seq-räkningar, av typen DESeq2: den differentiella analysen förblir utforskande på dessa data.
- Kliniska kohorter: projekttypen ”Klinisk kohort” har texten ”Kommer snart”.
- PDF-export av rapporten: projektets guide markerar den med ”Kommer snart”.
Innehåll
Upptäck Biodata
Importera dina data
Förbereda dina data
Analysera
Upptäck Biodata
1. Vad är Biodata, och vad betyder märket ”Beta”?
Biodata är Charlies modul för genuttrycksanalys, utan att skriva kod. Den öppnas från posten Biodata i vänstermenyn.
Märket ”Beta” i menyn och texten ”Tidig åtkomst” högst upp på skärmen visar att modulen är en förhandsversion. Vissa flikar och vissa analyser syns redan men är ännu inte aktiva. De listas överst på den här sidan, som bara beskriver som tillgängligt det som fungerar i dag.
Startsidan samlar dina projekt under ”Mina projekt” och dina filer under ”Mina filer”. Varje projektkort visar sin källa, sitt antal prover och gener och sin status, till exempel ”Klar”.
2. Vilka planer ger tillgång till Biodata?
Planerna Premium och Team ger tillgång till Biodata. Med gratisplanen presenterar sidan modulen och föreslår att du går över till Premium, men du kan inte skapa något projekt.
Antalet projekt beror på din plan: se Planer och begränsningar. Ett projekt gäller en datamängd. Antalet analyser i ett projekt är inte begränsat.
I ett team kan administratören inaktivera Biodata: posten försvinner då från menyn.
Om din prenumeration inte längre ger tillgång till Biodata är dina projekt låsta tills du tar en plan som inkluderar det. Om du har fler projekt än din plan tillåter, ta bort några för att återaktivera åtkomsten.
Importera dina data
3. Vilka data kan jag analysera?
Biodata analyserar en uttrycksmatris: en tabell som korsar gener och prover, med ett mätvärde per prov. Den accepterar microarrays och RNA-seq, men behandlingen och resultatens värde beror på skalan på dina data.
| Dina data | Utforskning (PCA, UMAP) | Differentiell analys |
|---|---|---|
| Microarrays i log2 | Värdena används som de är | Modererat t-test som standard, Welch-test efter val |
| RNA-seq som redan är i log (log-CPM, log2 TPM) | Värdena används som de är, om skalan ”Log-uttryck” identifieras eller deklareras | Samma behandling som microarrays, på samma villkor |
| RNA-seq i linjära värden (CPM, TPM, FPKM) | Automatisk omvandling till log2(x + 1) |
Omvandling till log2(x + 1), resultaten markeras som ”utforskande” |
| RNA-seq i råa räkningar | CPM-normalisering, sedan log2(CPM + 1) |
Omvandling till log2(x + 1), utan korrigering för sekvenseringsdjup: utforskande resultat |
Biodata accepterar inte filer med läsningar (FASTQ, BAM): den utgår alltid från en redan sammanställd matris.
En resultattabell (kolumnerna log2FoldChange, padj) är inte en uttrycksmatris. De kolumnerna föreslås för uteslutning, och importen stoppas om inget mätvärde per prov återstår.
4. Hur importerar jag en fil, och med vilka begränsningar?
Klicka på ”Nytt projekt”, välj ”Omikdata” och öppna sedan fliken ”Ladda upp en fil”. Biodata accepterar formaten .xlsx, .xls, .csv och .tsv.
Skärmen ”Importkonfiguration” visar en förhandsvisning och låter dig kontrollera:
- bladet som ska läsas, för en Excel-arbetsbok;
- ”Tabellens orientering”: ”Rader = gener” eller ”Rader = prover”;
- ”Typ av gen-id”: ”HGNC-symbol”, ”Ensembl”, ”Microarray-prob”, ”NCBI Entrez” eller ”Annat”;
- ”Organism”, obligatorisk utom med typen ”Annat”;
- ”Plattform (GPL)”, obligatorisk för prober;
- regeln som ska tillämpas på ”Duplicerade gener”, när filen innehåller sådana.
En fil får inte överstiga 50 MB, 80 000 gener och 500 prover. Dessa tak är desamma för alla planer. Arbetsböcker som innehåller makron avvisas.
Innan du startar importen måste du kryssa i ett intyg om anonymisering av data: se fråga 20.
Att importera en fil skapar ett projekt, som räknas mot din gräns. För att utgå från en redan importerad datamängd utan att skicka den på nytt, använd fliken ”Återanvänd en datamängd”.
5. Hur laddar jag en studie från GEO?
Klicka på ”Nytt projekt”, välj ”Omikdata”, öppna fliken ”GEO (NCBI)” och ange ett serie-id, till exempel GSE3494. Endast GSE-serier kan laddas. Åtgärden kan ta en till två minuter och fortsätter om du stänger fönstret.
Den automatiska inläsningen fungerar när GEO publicerar matrisen i sin standardfil, vilket är fallet för microarrays. För RNA-seq lägger GEO värdena i tilläggsfiler som är specifika för varje studie. Biodata meddelar dig det och hänvisar dig till studiens sida: ladda ner matrisen där och importera den sedan som en fil.
Om serien omfattar flera plattformar frågar Biodata vilken som ska analyseras. GEO-filen får inte överstiga 100 MB i komprimerat skick.
Från en session, när panelen Källor citerar en GEO-datamängd, öppnar knappen ”Analysera i Biodata” projektskapandet med id:t redan ifyllt. Inget laddas innan du bekräftar.
Förbereda dina data
6. Hur känner Charlie igen mina gener, och för vilka arter?
Charlie översätter dina identifierare till gennamn för nio arter, utifrån Bioconductors annoteringsdatabaser. Den ersätter också föråldrade namn med det aktuella namnet, genom att läsa synonymerna i NCBI Gene.
| Art | Annoteringsdatabas | Uppdatering av namn (referensnomenklatur) |
|---|---|---|
| Människa | org.Hs.eg.db | HGNC |
| Mus | org.Mm.eg.db | MGI |
| Råtta | org.Rn.eg.db | RGD |
| Sebrafisk | org.Dr.eg.db | ZFIN |
| Bananfluga | org.Dm.eg.db | FlyBase |
| C. elegans | org.Ce.eg.db | WormBase |
| E. coli | org.EcK12.eg.db | NCBI och EcoCyc |
| Arabidopsis thaliana | org.At.tair.db | Ingen uppdatering av namn |
| Jäst (S. cerevisiae) | org.Sc.sgd.db | Ingen uppdatering av namn |
För microarrays hanteras Illumina-modellerna för människa, mus och råtta, liksom Affymetrix-chipet E. coli Genome 2, via särskilda Bioconductor-paket. Övriga microarrays använder plattformsfilen som publiceras av NCBI.
Konverteringen av Ensembl-identifierare beror på artens databas. Den är inte tillgänglig för jäst: dessa identifierare förblir då oigenkända.
Blocket ”Annotering” i fliken ”Data” anger hur många identifierare som är ”Annoterade” och ”Ej annoterade”, varifrån namnen kommer, och en not som ”Tillförlitlig”, ”Bra” eller ”Delvis”. Identifierare utan gen exkluderas som standard. En ruta låter dig behålla dem.
När flera prober mäter samma gen behåller Biodata som standard den med högst intensitet. Vid import av en fil erbjuder menyn ”Duplicerade gener” andra regler. När en prob riktar sig mot flera gener bär den bara namnet på en av dem: skriv det andra namnet i gensökningen för att hitta dess mätvärde.
För en annan art är analysen fortfarande möjlig, utan uppdatering av namn. En GEO-serie behåller symbolerna i sin plattformsfil. En fil importeras med typen ”Annat”, som behåller dina identifierare som de är. Du kan sedan ladda din egen koppling med ”Ladda upp en egen annotering”: en CSV eller TSV på högst 10 MB, med kolumnerna probe_id och gene_symbol.
7. Hur anger jag plattformen för min microarray?
Med en GEO-serie behöver du inte göra något: plattformen läses från datamängden. Med en fil med prober fyller du i fältet ”Plattform (GPL)” vid importen.
Fältet föreslår vanliga microarrays och de som redan har hämtats, markerade ”Hämtad från NCBI”. Du kan också ange vilken kod som helst av formen GPL96: Charlie laddar då ner dess annotering från NCBI, och plattformen föreslås vid följande importer.
Om den valda plattformen och organismen inte stämmer överens blockerar meddelandet ”Inkonsekvens organism / plattform” importen tills det är åtgärdat.
8. Hur väljer Charlie behandlingen av mina data?
Charlie identifierar skalan på dina värden vid importen, och behandlingen följer av den. Den skiljer på tre fall.
| Skala | Identifieras när | PCA och UMAP | Differentiell analys |
|---|---|---|---|
| ”Log-uttryck” | Median mellan 2 och 16, maximum under 25, inget negativt värde; eller känd microarray | Ingen transformation | Ingen transformation |
| ”Råa räkningar” | Över 80 % heltalsvärden och maximum över 100 | CPM, sedan log2(CPM + 1) |
log2(x + 1), utforskande resultat |
| ”Skala ej identifierad” | Alla övriga fall, bland dem linjära TPM och FPKM | log2(x + 1) om maximum överstiger 50, annars ingen transformation |
log2(x + 1), utforskande resultat |
Negativa värden tyder på data som redan är i log eller centrerade: Charlie tillämpar då ingen logaritm på dem.
Om identifieringen blir fel, deklarera skalan i ”Dataförberedelse”: ”Log-uttryck”, ”Råa räkningar” eller ”Annan / okänd”. Din deklaration har företräde framför identifieringen. Gör det särskilt för data som redan är i log med låg median, som vissa log2 TPM. Annars tillämpar den differentiella analysen en andra logaritm på dem.
Att ändra skalan räknar inte om de analyser som redan har startats. De får märket ”skala att tillämpa igen”: kör dem på nytt.
9. Vad kan jag ställa in i fliken ”Data”?
Fliken ”Data” förbereder och beskriver din datamängd inför analysen. Den har tre block.
- Dataförberedelse: annotering, saknade värden, normalisering och skala.
- Skapa dina egna grupper: provgrupper som bildas för hand, eller automatiskt utifrån en variabel med ”Gruppera automatiskt efter”.
- Dataöversikt: ett utdrag ur matrisen, de kategoriska variablerna och ”Topp 50 mest variabla gener”.
Som standard exkluderas en gen vid över 30 % saknade värden. Tröskeln ställs in för hela projektet.
Kvantilnormalisering föreslås när kvalitetskontrollen hittar avvikande fördelningar mellan prover. Den är ditt beslut, och den avvisas på råa räkningar.
Kolumner som inte verkar vara gener visas under ”Icke-genetiska variabler”. Kryssa i dem som ska uteslutas från matrisen.
Analysera
10. Hur går en analys till?
Ett projekt har fem flikar, varav tre går att använda i dag: ”Data”, ”Analyser” och ”Korg”.
Förbered din datamängd i ”Data”. Lägg till steg i ”Analyser”, där de bildar din rapport. Samla de gener som intresserar dig i ”Korg”. Flikarna ”Anrikning” och ”Bibliografi” visar ”Kommer snart”.
11. Vilka analyser kan jag starta?
Knappen ”Lägg till” i fliken ”Analyser” öppnar listan över tillgängliga steg.
- Fördelning & jämförelse: ”Kvalitetskontroll”, ”Lådagram”, ”Histogram”, ”Räkningar”.
- Utforskning: ”PCA”, ”UMAP”, ”Scree-diagram”, ”Värmekarta”, ”Korrelation”.
- Differentiellt uttryck: ”Vulkandiagram”, ”MA-diagram”.
Övriga poster i listan har märket ”Snart”. En textanteckning läggs till i rapporten via chatten.
Vissa analyser kräver ett minsta antal prover: 3 för PCA, scree-diagrammet och korrelationen, 5 för UMAP.
Den differentiella analysen jämför två grupper åt gången. Biodata erbjuder varken parad design eller justering för batch eller kovariat.
12. Vad innehåller ett analyssteg?
Ett steg samlar grafen, dess inställningar och hur den togs fram.
- Grafen, med sina nyckeltal och kvalitetsvarningar.
- Inställningarna, som ändras innan du klickar på ”Kör igen”. På en volcano plot följer grafen trösklarna direkt, med en preliminär räkning; ”Kör igen” räknar om på alla gener.
- Bildtexten, som Charlie skriver när du klickar på ”Generera bildtexten”, och som du kan kopiera.
- ”Beräkningsdetaljer”: metoden, de tillämpade inställningarna och formlerna.
- Data som användes för grafen, i form av en tabell.
Ett steg har statusen ”validerad” eller ”utkast”. Bara ett validerat steg gör det möjligt att skicka gener till korgen.
Genereringen av bildtexter har ett dagligt tak per konto. Det gäller inte beräkningarna.
13. På en volcano plot, hur väljer jag test och korrigering?
Behåll standardinställningarna i de flesta fall: det modererade t-testet och Benjamini–Hochberg-korrigeringen. De ändras under ”Avancerade alternativ”.
En gen behålls om den passerar två trösklar samtidigt: log2 fold-change, som är 1 som standard, och det justerade p-värdet, som är 0,05 som standard.
| Dina data | Test att välja |
|---|---|
| Microarrays eller värden i log, små grupper | ”Modererat t-test (limma) — standard”: det stabiliserar varje gens varians utifrån alla gener, vilket hjälper när proverna är få |
| Samma data, grupper tillhandahållna | Modererat t-test eller ”Welch t-test”: skillnaden mellan dem minskar |
| Råa räkningar | Inget är lämpligt: resultaten förblir utforskande i väntan på en särskild metod |
Om det modererade t-testet inte kan skatta sina parametrar går Charlie tillbaka till Welch-testet och anger det i en varning.
Korrigeringen tar hänsyn till de tusentals tester som görs på en gång. Benjamini–Hochberg kontrollerar andelen falska upptäckter. ”Benjamini-Yekutieli (konservativ)”, ”Bonferroni (mycket konservativ)” och ”Holm (nedåtgående)” är strängare och kan utplåna en verklig signal. ”Ingen (rekommenderas ej)” är förbehållen erfarna användare, eftersom risken för falska positiva är hög.
Gruppernas storlek begränsar vad du kan dra för slutsatser. Med ett enda prov i en grupp är inget test möjligt. Med två är den statistiska styrkan mycket begränsad, och den förblir begränsad med tre eller fyra. Startfönstret varnar för små grupper. En skillnad på mer än 2 mot 1 mellan grupperna utlöser en varning på resultatet.
Innan du lättar på trösklarna, kontrollera att dina två grupper utgör en verklig biologisk kontrast. Blocket ”Finns det signal?” i ”Beräkningsdetaljer” jämför antalet erhållna gener med det antal som förväntas av slumpen.
14. Vad kan assistenten göra i ett projekt?
Assistenten svarar på dina frågor om din datamängd, dina steg och din korg, utifrån dina verkliga värden. Den kan:
- läsa statistiken för en kolumn, en gens värden och annoteringens detaljer;
- läsa resultaten av ett steg och jämföra dess versioner;
- föreslå en analys i ett kort ”Analysförslag”, som du kontrollerar innan du startar den;
- lägga till gener i korgen och anteckningar i rapporten;
- ge referensinformation om en human-, mus- eller råttgen.
Den startar inga beräkningar utan din bekräftelse, definierar inte dina jämförelsegrupper och kör ingen kod. Den söker inte heller i litteraturen från ett projekt: öppna en Charlie-session för det.
Varje fråga räknas som en förfrågan, precis som i en session: se Planer och begränsningar. Om konversationen blir för lång blockeras sändningen: starta en ”Ny konversation”.
15. Vad används korgen till?
Korgen är din arbetslista med gener. Du lägger till gener i den från ett validerat steg, från ”Topp 50 mest variabla gener”, för hand eller via chatten.
För varje gen anger den vilka steg den kommer från, med en länk till vart och ett. Du ser på så sätt vilka gener som återfinns i flera analyser.
Funktionell anrikning utifrån korgen (GO, KEGG, Reactome) är ännu inte tillgänglig. Fliken ”Anrikning” aviserar den som ”Kommer snart”.
16. Kan jag exportera mina figurer och min rapport?
Inte ännu. Biodata erbjuder i dag varken PDF-export av rapporten eller nedladdning av figurerna.
Du kan kopiera en bildtext med ”Kopiera bildtexten”, och ta över inställningarna och metoden från ”Beräkningsdetaljer”.
Tillförlitlighet och sekretess
17. Hur vet jag om min analys är tillförlitlig?
Börja med varningarna: Charlie visar dem där du konfigurerar analysen och i själva steget. De pekar bland annat på:
- grupper som är för små eller obalanserade;
- en osäker skala, eller råa räkningar i en differentiell analys;
- avvikande prover i en PCA, eller en instabil UMAP-projektion;
- avsaknad av signal över bruset, när de erhållna generna inte överstiger det som slumpen skulle ge.
Varningarna fattar inga beslut åt dig. De minskar risken att dra slutsatser på ett skört underlag utan att veta om det, men de ersätter inte ditt vetenskapliga omdöme. Inför en publicering, låt en bioinformatiker eller en biostatistiker granska analysen.
18. Görs beräkningarna av AI?
Nej. Analyserna beräknas av statistikprogram, utifrån värdena i din matris. Språkmodellen kommer in därefter för att skriva bildtexterna och svara på dina frågor. Läs igenom dessa texter som all genererad text.
Beräkningarna är skrivna i Python och bygger på NumPy, SciPy, scikit-learn och umap-learn. De går inte via R. Det modererade t-testet följer Smyths metod (2004), omskriven i Python för en jämförelse mellan två grupper: det är inte själva limma-paketet.
I avsnittet ”metoder” i en artikel, beskriv därför det som har körts utifrån ”Beräkningsdetaljer”, utan att skriva att analysen gjordes med limma under R.
19. Var behandlas mina data?
Charlies kärna, bland annat dina filer och Biodatas beräkningar, hostas och drivs i Frankrike.
Biodatas chatt och bildtexter använder alltid ”Config B – Europa (Frankrike)”, oavsett vilken konfiguration som valts i dina sessioner. Modellerna körs inom Europeiska unionen, utan träning på dina data. Detaljerna finns i Modeller och integritet.
För att ladda en serie eller en plattform frågar Charlie NCBI med dess offentliga identifierare (GSE eller GPL). Dina egna data skickas inte till NCBI.
20. Kan jag importera patientdata?
Bara om de inte gör det möjligt att identifiera en person. Charlie är inte certifierad som hostingleverantör av hälsodata, och artikel 8 i användarvillkoren förbjuder att lämna in hälsodata som avser en identifierad eller identifierbar person.
Vid import av en fil måste du intyga att datamängden ”är anonymiserad eller pseudonymiserad”, att den inte innehåller någon direkt identifierare (namn, födelsedatum, personnummer, e-postadress, journalnummer) och att kopplingstabellen inte lämnas in i Charlie. Utan att rutan är ikryssad startar importen inte.
Charlie flaggar också kolumner som liknar direkta identifierare. Du ansvarar själv för de data du lämnar in. GEO-serier, som är offentliga, kräver inte detta intyg.
21. Vad händer om jag raderar ett projekt eller en fil?
Att radera ett projekt raderar inte dess fil: den finns kvar i ”Mina filer” och kan användas av andra projekt.
Det raderade projektet, dess steg och dess chattsessioner raderas definitivt efter 30 dagar.
En fil kan bara raderas om inget aktivt projekt använder den.
Åtgärden ”Duplicera” skapar ett nytt projekt på samma datamängd, utan ny uppladdning.
22. Hur har behandlingen av RNA-seq validerats?
Behandlingen har kontrollerats på två publicerade datamängder vars biologi är känd: airway (Himes et al., 2014, glatta muskelceller från luftvägarna behandlade med dexametason) och pasilla (Brooks et al., 2011, knockdown av genen Pasilla hos bananflugan).
Dessa kontroller verifierar att skalan identifieras korrekt, att sekvenseringsdjupet väger mindre i PCA efter förberedelsen, att de förväntade grupperna skiljs åt och att de förväntade generna framträder åt rätt håll. CRISPLD2 ska induceras av dexametason, och Pasilla repressas där den har slagits ut.
Deras räckvidd är begränsad. De gäller dessa två datamängder och garanterar inte en analys av dina data. De omfattar inte microarrays. Deras differentiella analys använder Welch-testet, och de syftar inte till överensstämmelse på siffran när med DESeq2.
Analysera din första matris
Skapa ditt Charlie-konto och gå sedan över till planen Premium eller Team för att öppna ditt första Biodata-projekt.
Skapa ett konto